Redija documentos de clientes sem enviá-los a lugar nenhum.
O Qvault encontra nomes, números de documentos, endereços, dados bancários e outros dados pessoais em PDFs, arquivos do Word e páginas digitalizadas. Você revisa cada ocorrência e depois exporta uma cópia em que o texto redigido foi realmente removido.
macOS, Windows e Linux · licença MIT · sem conta, sem chave de licença, sem telemetria
Leia o artigo: por que criei o Qvault e o que as medições mostraram (em inglês) →
Seus documentos ficam no seu dispositivo.
Os documentos são abertos, analisados, revisados e exportados localmente. Nenhum documento, texto extraído ou resultado de detecção é enviado a nós ou a terceiros. Não há nenhum serviço em nuvem por trás do Qvault.
Nenhum dado dos documentos sai do dispositivo
Extração de texto, OCR, detecção e exportação rodam no seu computador. Os documentos importados ficam em uma pasta privada no seu computador; proteja-a com criptografia de disco completo.
Rede só para os modelos que você pedir
O único uso da rede é o download opcional de um modelo, iniciado por você. O Qvault mostra antes o tamanho do arquivo, baixa por HTTPS e confere o SHA-256 antes de usar o modelo.
Funciona totalmente offline
As camadas 1 e 2 não precisam de modelo algum. Os modelos de IA podem ser importados de um arquivo, então máquinas isoladas da rede podem usar todos os recursos.
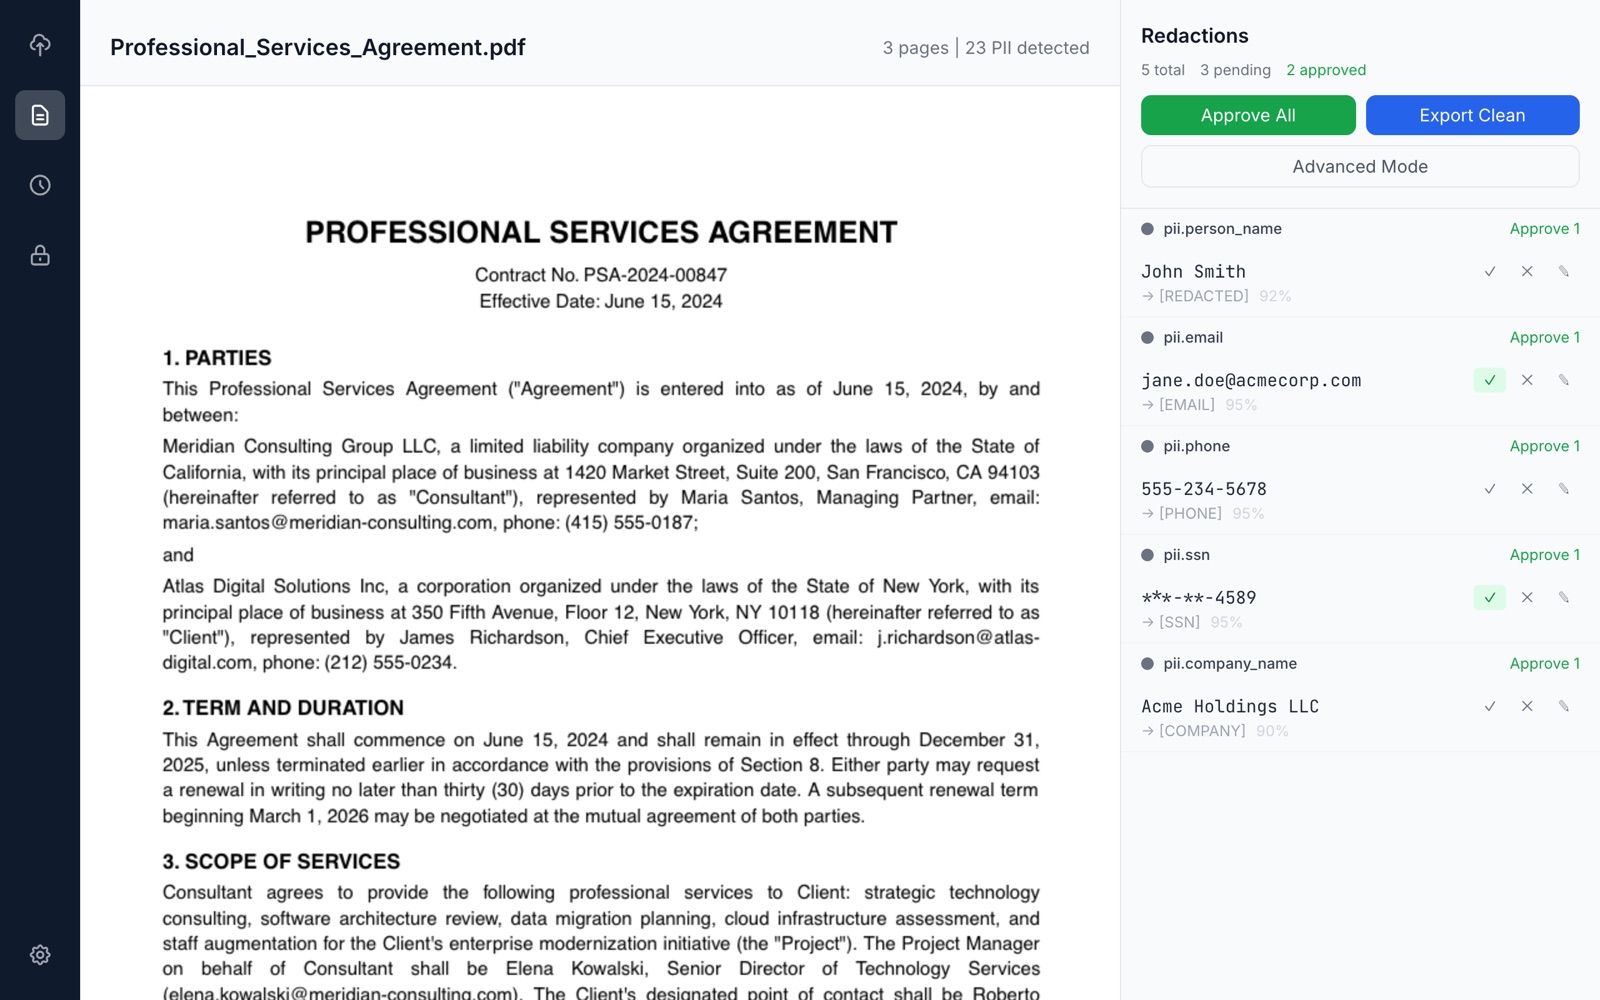
Abrir, revisar, exportar.
1 Abra um documento
Arraste um PDF, um DOCX ou uma página digitalizada (PNG, JPG, TIFF). O Qvault extrai o texto, usando OCR no próprio dispositivo quando não há camada de texto, e procura dados pessoais.
2 Revise cada ocorrência
Cada detecção aparece destacada no documento com sua categoria, grau de confiança e a camada que a encontrou. Aprove, rejeite ou edite, ou selecione um trecho para adicionar suas próprias redações.
3 Exporte uma cópia limpa
Só as redações aprovadas são aplicadas. O Qvault relê o arquivo exportado e se recusa a salvá-lo se algum texto aprovado ainda puder ser encontrado nele.
Três camadas que se complementam.
Cada camada encontra o que a anterior deixou passar. As camadas seguintes ignoram o texto que uma camada anterior já identificou.
1 Padrões
Expressões regulares para dados estruturados: e-mails, telefones, números de cartão, IBAN, endereços IP, URLs, datas e valores, além de conjuntos por jurisdição para os EUA (SSN, EIN), a UE (números de IVA), o Brasil (CPF, CNPJ, CEP) e a Alemanha (Steuernummer).
2 Heurística
Regras de contexto para o que um padrão não consegue descrever: nomes de pessoas (pronomes de tratamento, cargos, “representada por”), razões sociais com tipo societário (LTDA, EIRELI, S.A., LLC, GmbH…) e endereços.
3 IA local opcional
O OpenAI Privacy Filter rotula cada página de uma vez e sugere dados pessoais que as regras não pegam; depois pode rodar uma revisão minuciosa opcional com um modelo de linguagem pequeno. Ele roda com o SDK QVAC da Tether em um processo auxiliar incluído no aplicativo, que conversa com o Qvault por entrada e saída padrão e não abre nenhum socket de rede.
Nada é redigido automaticamente.
Ferramentas de detecção erram para os dois lados. O Qvault trata cada ocorrência como uma sugestão: mostra o texto, a categoria, a confiança e a camada (padrão, heurística ou IA) para que você decida, e aplica apenas o que você aprovar.
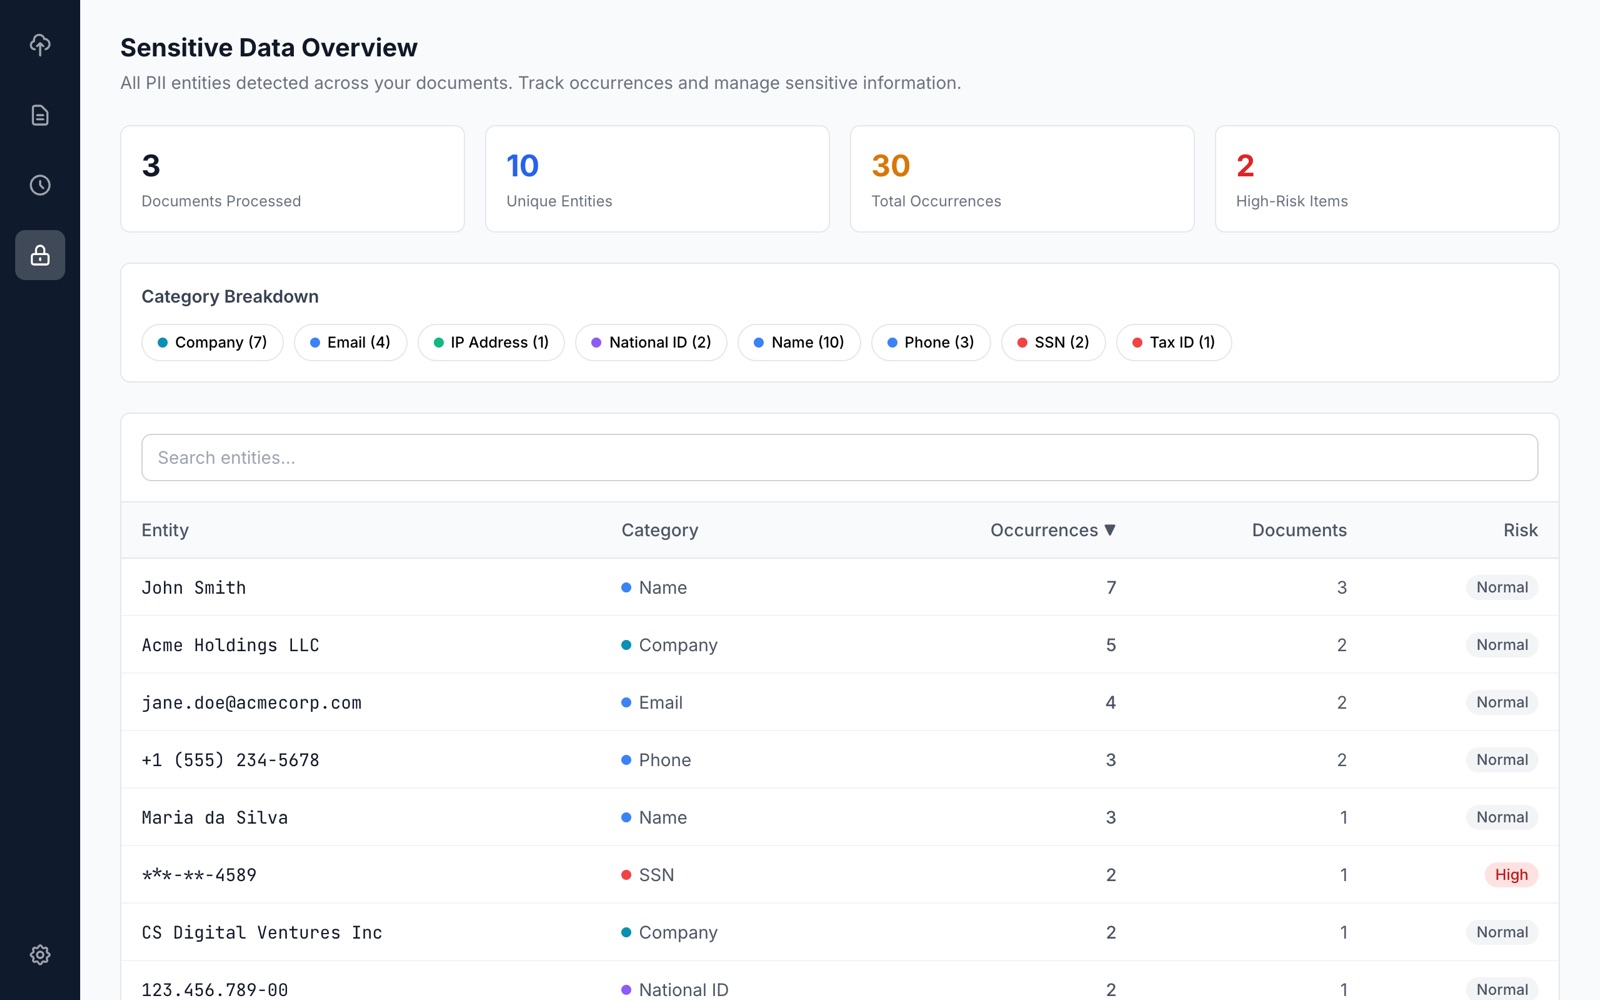
- Aprove ou rejeite uma ocorrência, todas as repetições dela ou tudo de uma vez.
- Modo avançado: selecione qualquer trecho do documento para adicionar uma redação manual.
- Os grupos de entidades ligam as diferentes grafias de um mesmo nome ou número nos seus documentos (“Maria Santos”, “Santos, Maria”, “Sra. Santos”). Correspondências incertas aguardam a sua revisão, e um nome conhecido que os detectores não encontraram num documento novo é sugerido para redação.
- Um registro de auditoria anota as ações (envios, análises, aprovações, exportações, mudanças de modelo) sem guardar o texto dos documentos.
PDFs digitalizados e imagens, lidos no seu computador.
Muitos autos e documentos são digitalizações sem camada de texto. O Qvault faz o reconhecimento óptico de caracteres localmente com o QVAC OCR: um detector de texto CRAFT no estilo do EasyOCR e um reconhecedor de alfabeto latino, ambos como modelos GGUF na sua máquina.
O que abrange
- Páginas de PDF digitalizadas ou compostas só de imagens.
- Imagens PNG, JPG e TIFF.
- Idiomas de alfabeto latino, como português, espanhol, inglês, alemão e francês.
- O texto reconhecido passa pelas mesmas três camadas e pela mesma revisão.
O que esperar
O OCR roda na CPU e leva segundos por página, não milissegundos. O reconhecimento nunca é perfeito: revise digitalizações com cuidado redobrado, principalmente e-mails e números quebrados entre linhas.
Os dois arquivos de modelo de OCR são baixados manualmente, uma única vez. Veja o passo a passo e as somas de verificação.
Redações que não podem ser desfeitas com copiar e colar.
Um retângulo preto desenhado sobre um texto não é uma redação se o texto continua por baixo. O Qvault remove o texto.
- Cada página com uma redação aprovada é convertida em imagem e os retângulos são gravados nos pixels. O texto, as fontes e as anotações originais dessa página são descartados.
- Metadados do documento, XMP, marcadores, formulários, anexos e scripts são removidos de todo o arquivo.
- A exportação é recusada se uma redação aprovada não puder ser posicionada na página ou se um texto aprovado aparecer em uma página que não será redigida.
Word (DOCX)
- Redação ciente dos trechos de formatação: um texto dividido em vários trechos ainda é encontrado e substituído.
- Abrange corpo, cabeçalhos, rodapés, notas de rodapé e de fim, comentários e controle de alterações; o texto excluído nas revisões é removido.
- Autores de comentários e revisões e as propriedades do documento são apagados, e a miniatura da página é removida.
Toda exportação é verificada. Depois de gravar o arquivo, o Qvault extrai o texto dele novamente. Se algum texto aprovado sobreviver, o arquivo é apagado e a exportação falha com uma explicação.
Um aplicativo desktop feito para revisão.
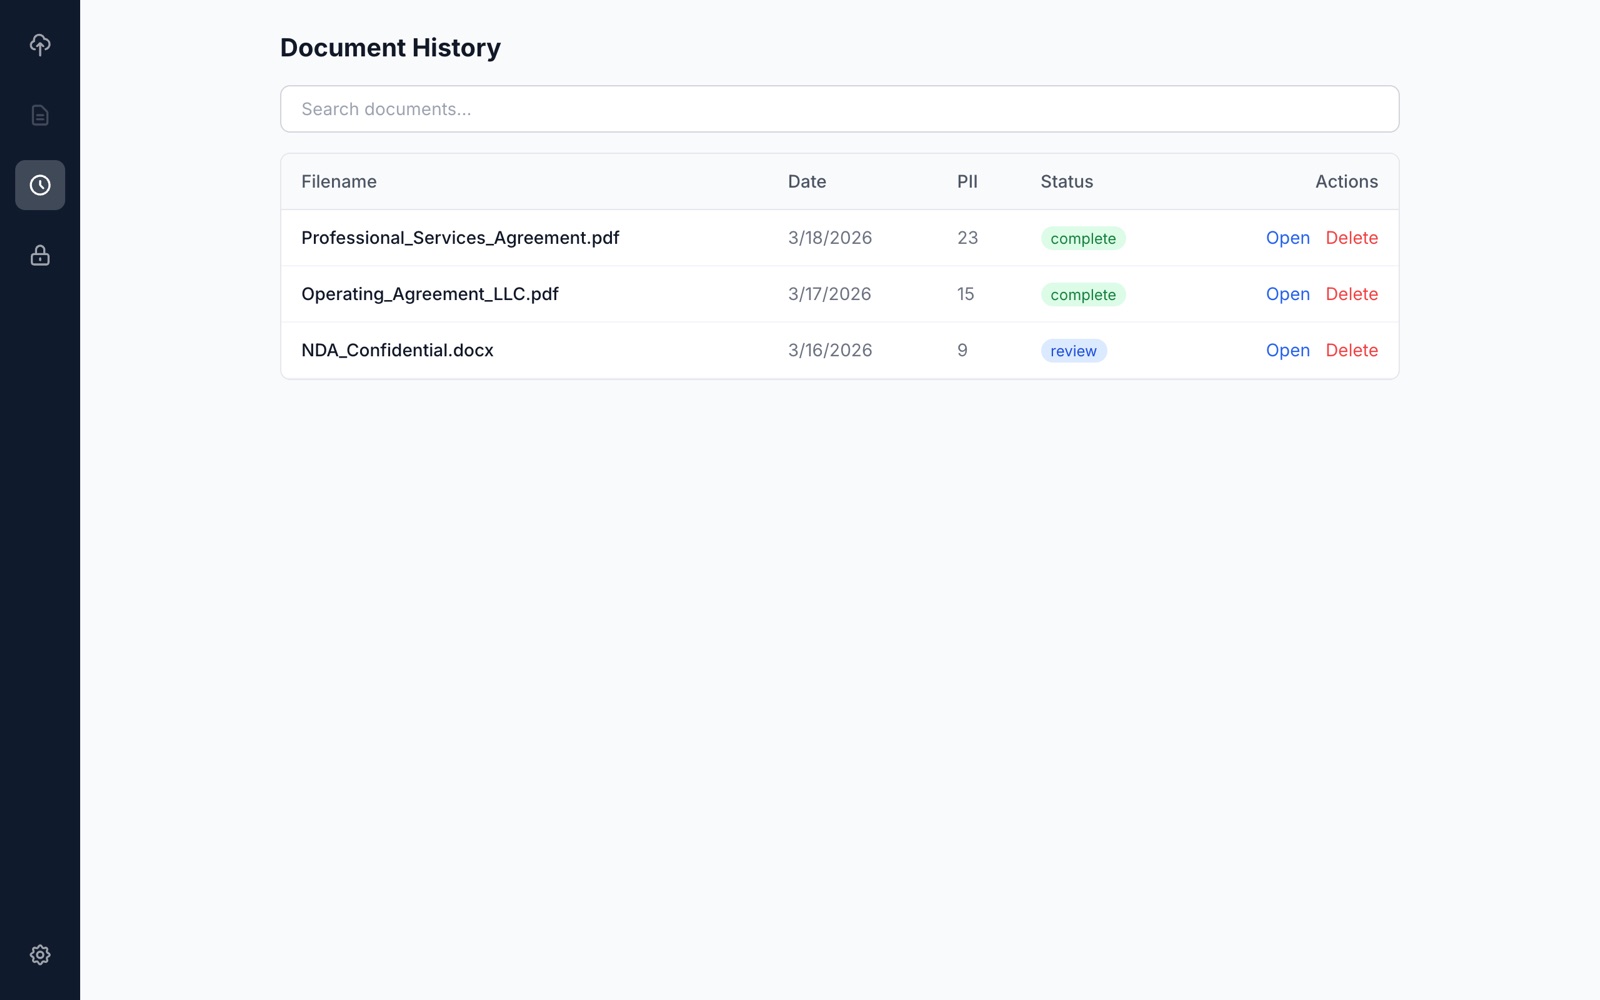
As capturas são de uma versão anterior, em inglês; a tela de Configurações atual inclui também o gerenciador de modelos de IA.
Antes e depois.
Um contrato fictício de prestação de serviços de três páginas, em inglês e cheio de dados pessoais, e uma versão redigida dele. Teste o original no Qvault e compare.
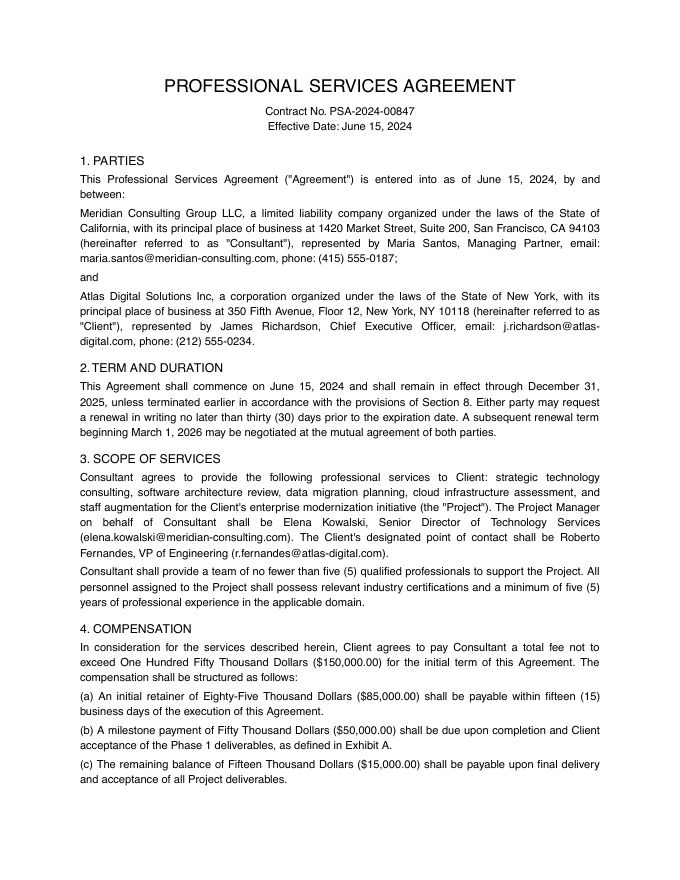
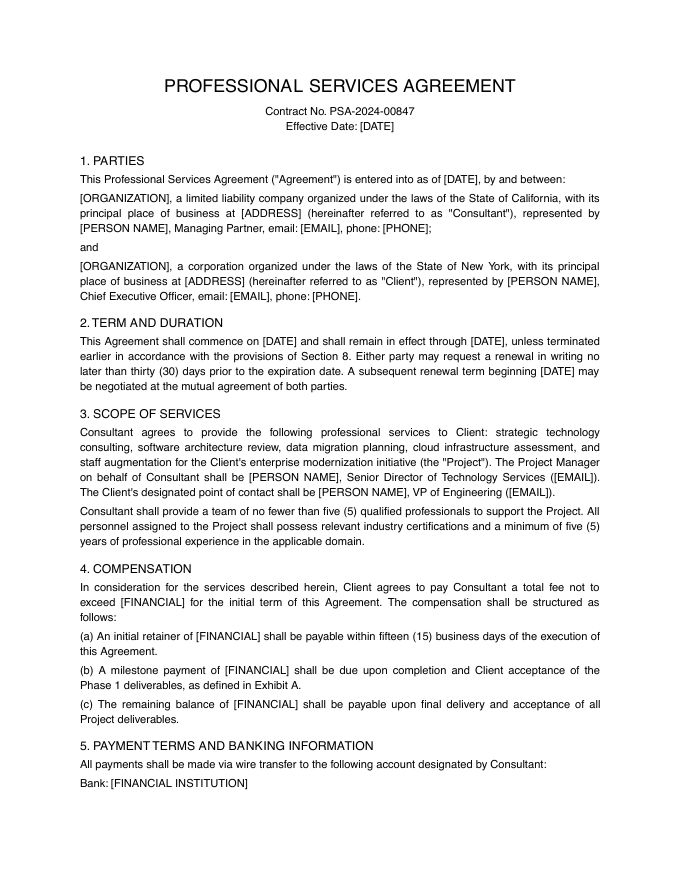
A versão redigida ilustra o resultado de uma revisão completa com etiquetas de categoria. Uma exportação real de PDF pelo Qvault grava retângulos pretos em imagens de página, como descrito acima. O que o Qvault encontra sozinho depende das camadas ativadas; alguns itens deste exemplo, como os códigos de roteamento bancário e SWIFT, podem exigir uma redação manual.
IA de código aberto, no seu próprio computador.
Os recursos de IA do Qvault usam modelos e software de código aberto. Tudo roda localmente; nada é enviado a esses projetos.
QVAC da Tether
O SDK de código aberto da Tether para IA local. O Qvault usa a inferência baseada em llama.cpp e o OCR dele num processo auxiliar incluído, que se comunica apenas por entrada e saída padrão.
OpenAI Privacy Filter padrão
Um modelo de pesos abertos feito para encontrar dados pessoais: rotula uma página inteira de uma vez e devolve os trechos exatos. É o detector de IA padrão do Qvault, executado pelo complemento ONNX do QVAC: no nosso conjunto de teste encontrou mais dados e sugeriu menos falsos positivos que o Qwen3-1.7B, com cerca de 0,2 segundo por página em CPU.
Qwen3
Modelos de linguagem da equipe Qwen. Usados na revisão minuciosa opcional da camada 3: Qwen3-1.7B por padrão, e também 0.6B, 4B e 8B.
EasyOCR e CRAFT
O detector de texto e o reconhecedor latino do OCR local, como arquivos GGUF convertidos para o QVAC.
Nomic Embed Text v2
Um modelo de embeddings opcional que acrescenta propostas por similaridade ao agrupar variantes de nomes.
Os avisos de licença completos estão em ATTRIBUTION.txt.
Gratuito para todos, para sempre.
O Qvault é publicado pela Santacroce SL sob a licença MIT. Os instaladores de todas as plataformas ficam no GitHub.
- macOS (Apple Silicon e Intel)
- Windows
- Linux (.deb, AppImage)
Os instaladores ainda não têm assinatura de código. Se o macOS disser que não consegue verificar o app, abra Ajustes do Sistema → Privacidade e Segurança e clique em Abrir Mesmo Assim. No Windows, escolha Mais informações → Executar assim mesmo no SmartScreen.
O código-fonte inclui versões para celular, mas a IA e o OCR estão disponíveis apenas no desktop. Precisa de ajuda para implantar o Qvault no seu escritório? Escreva para info@santacroce.es.